지능을, 부착합니다.
자체 LLM 기반 온디바이스 AI: 플랫폼을 건드리지 않고 로봇과 물리 시스템에 얹습니다.

저희가 공급하는 것
제조사와 사전 협업 없이 로봇에 부착되는 피지컬 AI 완성 세트: 소프트웨어와 하드웨어 일체.
소프트웨어
VLM
자체 LLM 기반 비전-언어 모델: 인지와 언어를 한 스택에서.
Harness
모델 출력을 로봇 동작·안전 한계에 묶는 제어 하네스.
VKAE · VKUE · VKIE
자체 추론 가속·경량화 엔진: 지연, 저사양 구동, 처리량을 각각 담당.
하드웨어 구성
3D 뎁스카메라 · 라이다
스피커 · 마이크
AP · 배터리
추가 센서
배터리
1회 충전 9시간 독립 구동
설계부터 제3자 방식
저희는 제3자로서 로봇에 지능과 인지를 더합니다: 제조사와의 제휴도, 펌웨어 포크도, 플랫폼 변경도 없습니다. 보스턴 다이내믹스 Spot에 붙인 것과 같은 세트를 이미 현장에 있는 다른 기계에도 적용할 수 있습니다.
왜 온디바이스인가
클라우드 AI가 물리 시스템에서 풀지 못하는 세 가지 제약.
지연
음성 명령에 반응하는 로봇은 왕복 통신을 기다릴 수 없습니다. 추론이 센서 곁에서 일어나야 합니다.
망 분리
국방·산업·공공 현장은 외부망 없이 운용되는 경우가 많습니다. 모델이 오프라인에서 동작해야 합니다.
개조 없는 적용
이미 배치된 시스템은 AI를 위해 다시 만들어지지 않습니다. 지능이 부착물로 도착해야 합니다.
외산 로봇이 한국어를 알아듣기까지
로봇은 보스턴 다이내믹스가 만듭니다. 한국어를 알아듣게 만든 것은 저희입니다: 제3자로서, 그들의 플랫폼을 건드리지 않고.
출고 상태
Spot은 보스턴 다이내믹스가 만든 4족 보행 로봇입니다. 출고 상태로는 한국어를 이해하지 못합니다.
로봇을 개조하지 않았습니다
펌웨어를 건드리지도, 제조사와 제휴하지도 않았습니다. 온디바이스 AI 모듈을 부착했을 뿐입니다.
한국어를 넣으면, 행동이 나옵니다
관람객이 한국어로 말하면, 기기 위의 모델이 의도를 해석하고 로봇이 그대로 움직입니다.
실제로 운영 중입니다
서울 로봇인공지능과학관에 상설 전시로 배치돼, 일반 관람객을 상대로 가동 중입니다. 연구실 데모가 아닙니다.
이것이 사업적으로 중요한 이유
현장에 이미 배치된 물리 시스템 대부분은 AI를 위해 다시 만들어지지 않습니다. 지능을 부착 가능한 온디바이스 모듈로 얹을 수 있다면, 이미 깔린 설치 기반 전체가 시장이 됩니다, 제조사의 참여 없이도. 이것이 저희 피지컬 AI 사업의 온디바이스 AI 공급 모델입니다.
이 영상이 보여주는 것
관람객이 한국어로 말을 겁니다. Spot에 장착된 저희 온디바이스 모델이: 클라우드 연결 없이 로봇 위에서 직접, 의도를 해석하고, Spot이 그대로 움직입니다. 로봇은 아무것도 개조하지 않았습니다. 지능이 부착물로 도착한 것입니다. 저희가 무엇을 파는지가 이 한 장면에 다 들어 있습니다.
Spot
제원은 제조사 공개 기준. 저희 세트는 14 kg 탑재 허용 범위 안에서 장착되며, 로봇 자체는 개조하지 않습니다.
원격조종 로봇개를 온디바이스 자율보행 로봇으로
중국산 저가형 원격조종 사족보행 로봇에 NVIDIA Jetson 기반 온디바이스 모듈과 VLM, LiDAR, 3D 깊이 카메라를 결합해 목적지 기반 자율보행 시스템으로 전환했습니다.
이번 현장 실증에서 확인한 것
이동 방향과 목적지를 매핑하면 로봇이 스스로 위치를 추정하고, 사람의 지속적인 조종 없이 목적지까지 이동한 뒤 엎드림 동작으로 임무 완료를 알립니다.
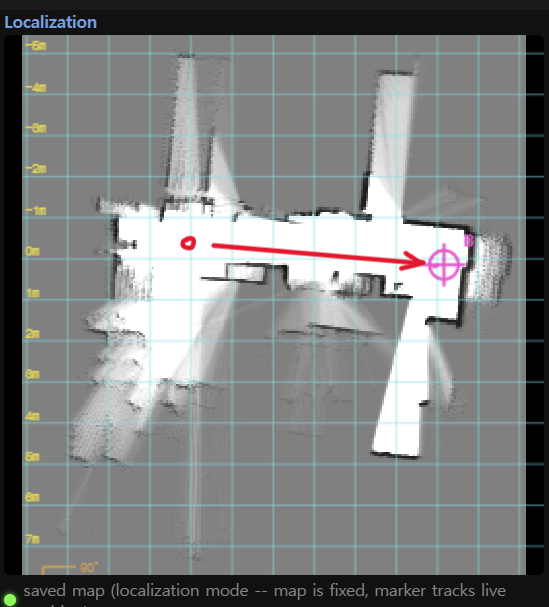
지도를 선택하면 원본 크기로 볼 수 있습니다.
LiDAR · 3D 깊이
주변 공간의 구조와 장애물을 인식합니다.
NVIDIA Jetson · VLM
로봇 위에서 인식과 판단 로직을 실행합니다.
위치 추정 · 매핑
현재 위치를 추적하며 설정된 목적지로 이동합니다.
도착 · 엎드림
마지막 동작으로 임무 완료를 명확히 알립니다.
자연어 음성 명령·행동·응답
다음 실험에서는 사람이 음성으로 지시하면 로봇이 명령을 이해해 행동하고, 자신의 상태와 주변 환경에 관한 질문에도 음성으로 응답하게 합니다.
실증 구축: 서울 인공지능·로봇 과학관
비드래프트가 구축해 시민에게 운영 중인 전시 3건.
스팟과 대화하기
보스턴 다이내믹스 Spot이 한국어 음성을 알아듣고 행동합니다: 로봇을 개조하지 않고, 제3자인 저희가 온디바이스 AI를 부착해 구현했습니다.
모델 X-RAY
LLM 블랙박스 내부를 들여다본다: 모델 내부 작동을 관람객에게 투명하게 보여주는 X-RAY.
다윈 교배·진화
AI 모델이 교배·진화하는 과정을 직접 본다: 자식이 부모를 뛰어넘는다. 인터랙티브 다윈 진화 체험.